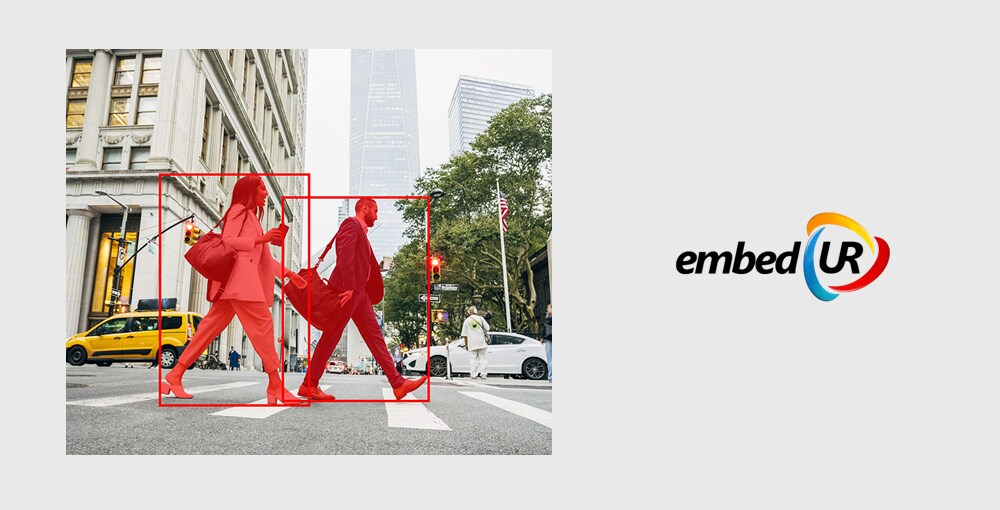
解决思路
某客户正在开发一款用于室内监控的紧凑型AI视觉产品,希望为系统加入场景上下文 和视觉智能 。目标是识别并分离视频流中的人物、背景、物体等区域,从而实现定向照明、安全触发、设备交互等更智能的自动化。受成本和外形尺寸限制,该方案必须直接运行在微控制器上。
传统方案各有明显局限。服务器或云端分割 能提供高分辨率输出,但需要联网,会带来隐私风险,还会产生持续的云成本。PIR或运动传感器 功耗很低,但缺乏视觉理解能力,无法判断场景类型或物体类别。高功率AI加速器 速度快、稳健性强,但对受限的嵌入式外形来说过于昂贵、体积过大。
embedUR对语义分割模型进行了量化和优化,使其可在STM32N6上运行,从而以紧凑、高能效的方式实现实时视觉理解。该模型可直接对低功耗摄像头采集的视频流进行像素级分类。
这种边缘AI方案的关键优势:
- 无需外部加速器:完整分割流水线仅靠STM32N6运行,物料清单中不再需要额外芯片
- 实时推理:设备端每帧低于100 ms
- 像素级场景理解:不仅能检测运动,还能识别每个人的存在、位置和轮廓
- 高能效设计:满足电池供电和常开产品的限制
- 紧凑集成:可在狭小空间内部署摄像头模块
- 隐私保护设计:视频帧在本地处理,绝不离开设备
应用概述
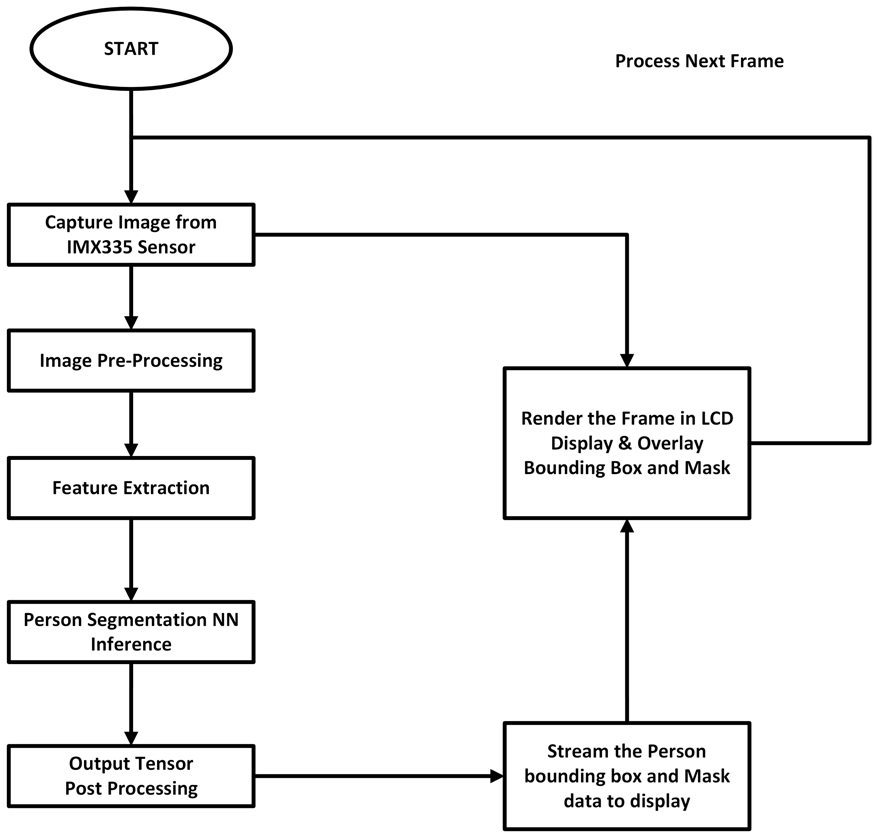
系统从连接STM32N6微控制器的摄像头传感器采集实时视频帧,并通过实时分割流水线处理。
1. 帧采集与缓冲
每个视频帧都会在内存中复制一份。其中一份送入显示流水线,通过双缓冲渲染进行实时可视化,确保输出流畅、无闪烁。另一份进入AI处理路径。
2. 预处理
帧会被缩小并预处理为224×224分辨率,这是神经网络推理所需的输入格式。
3. 实例分割推理
预处理后的帧送入部署在设备上的YOLACT神经网络。该模型执行两项关键操作:目标检测(生成边界框和置信度分数)和实例分割(利用学习到的原型掩码 和每实例系数,为每个检测到的人计算唯一掩码)。
4. 后处理与显示
非极大值抑制 (NMS) 会细化检测结果,掩码经过合并和阈值处理,将个体与背景分离。检测到的人数和分割掩码会叠加到原始帧上,并实时渲染到显示器。
技术细节
该解决方案基于YOLACT,这是一种针对嵌入式部署优化的实时实例分割神经网络。与传统逐像素分割网络不同,YOLACT利用一组全局原型掩码和逐实例系数,将检测与掩码生成分开。这种架构在保持分割精度的同时,显著降低了计算复杂度。
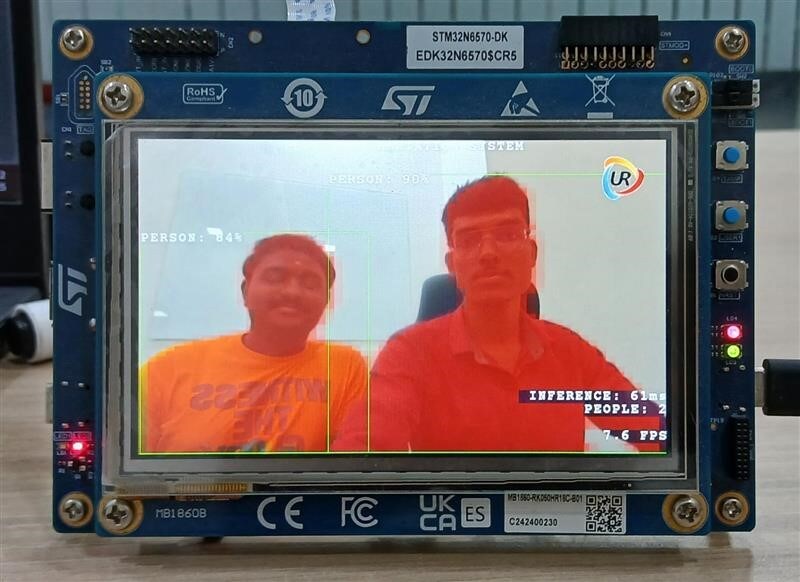
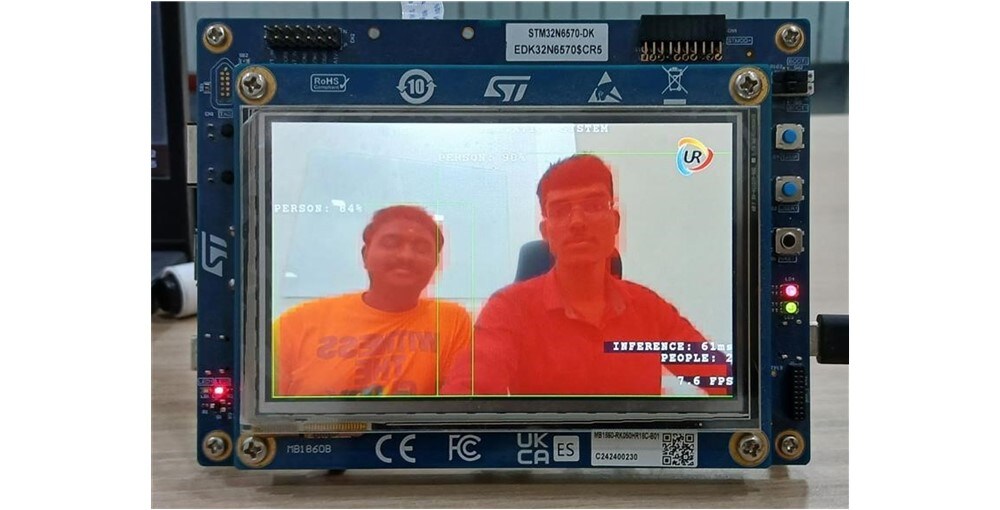
上图展示了人物检测与分割过程。一旦在帧中检测到个体,系统会验证其存在,并为每个人生成分割掩码。帧中识别出的总人数也会实时显示。
借助ST Edge AI工具,模型经过量化并部署到STM32N6系列微控制器上,使完整AI流水线可在本地运行。
- 实时性能:即使帧中有多人,也能保持准确率
- 高分割精度:基于原型的轻量级掩码生成技术
- 低时延处理:完全在设备端运行,无需云端传输数据
- 流畅显示输出:双缓冲渲染带来无缝用户体验
传感器
该应用使用基于IMX335 CMOS图像传感器构建的MB1854B 摄像头模块。对于实例分割而言,图像质量会直接影响掩码精度:稳定的色彩保真度和锐利边缘有助于网络清晰区分人物与背景,而跨帧稳定的曝光则能在多人穿过场景时保持掩码轮廓稳定。IMX335既能提供这种细节表现,又具备可靠的低光 性能,因此输入模型的RGB帧在多种室内光照条件下都能保持可靠。
模型与结果
模型:
- YOLACT(实例分割)
- 输入尺寸:224 x 224
- 通过ModelNova (embedUR) 针对STM32N6部署进行优化和量化
结果:
- 推理时间:61 ms
- 后处理时间:1 ms
- FPS:~14
- 部署:完全在设备端,STM32N6系列
软件工具
- STM32Cube AI Studio,用于神经网络转换与部署
- ST Edge AI Core 命令行接口
- STM32CubeIDE,用于应用开发和调试
- STM32CubeProgrammer, 用于将固件烧录到目标设备

资源
通过STM32Cube AI Studio优化
STM32Cube AI Studio是一款桌面工具,用于评估、优化和编译STM32微控制器的神经网络模型。该工具完全支持针对Neural-ART加速器神经处理单元 (NPU) 的编译。它取代了意法半导体AI产品线中的X-CUBE-AI,以涵盖新款STM32器件。
最适用于STM32N6系列
STM32系列32位微控制器基于Arm Cortex®-M处理器,旨在为MCU用户提供新的开发自由度。该系列产品结合了高性能、实时功能、数字信号处理、低功耗/低电压操作和出色的连接性,同时保持高度集成和易于开发的特点。