解决思路
在消费电子和工业语音接口中,来自机械、交通或环境声的背景噪声会显著降低语音识别准确率。智能家电、对讲设备与可穿戴设备等产品需要清晰的音频输入,但传统方案往往各有明显取舍。
专用DSP芯片 会增加硬件成本、功耗与集成复杂度。云端语音增强 需要联网,会引入延迟,并带来隐私顾虑。MCU上的传统滤波技术 在动态、多声源噪声环境中效果有限,面对真实场景的泛化能力也较差。
为此,embedUR在STM32N6微控制器上直接部署了一个紧凑型神经网络。该模型经过量化和优化,完全在现有片上存储器中运行,无需额外硬件即可实现实时噪声抑制 。
这种边缘AI方案的关键优势:
- 降低成本:无需专用DSP芯片或云订阅
- 超低延迟:实时逐帧处理确保灵敏的用户交互
- 高能效:在STM32N6的超低功耗范围内运行,非常适合电池供电或常开设备
- 更高准确率:提升真实噪声环境(工厂、交通、室内对话)下的关键词检测率
- 完全离线能力:非常适合注重隐私或连接受限的环境
该方案表明,嵌入式AI能为音频类设备带来新能力:即使最小的产品,也能实现智能、灵敏且高性价比的噪声抑制。
应用概述
音频降噪流水线在设备端完成:采集含噪信号,经神经网络处理,实时输出清晰音频。
1. 信号采集与变换
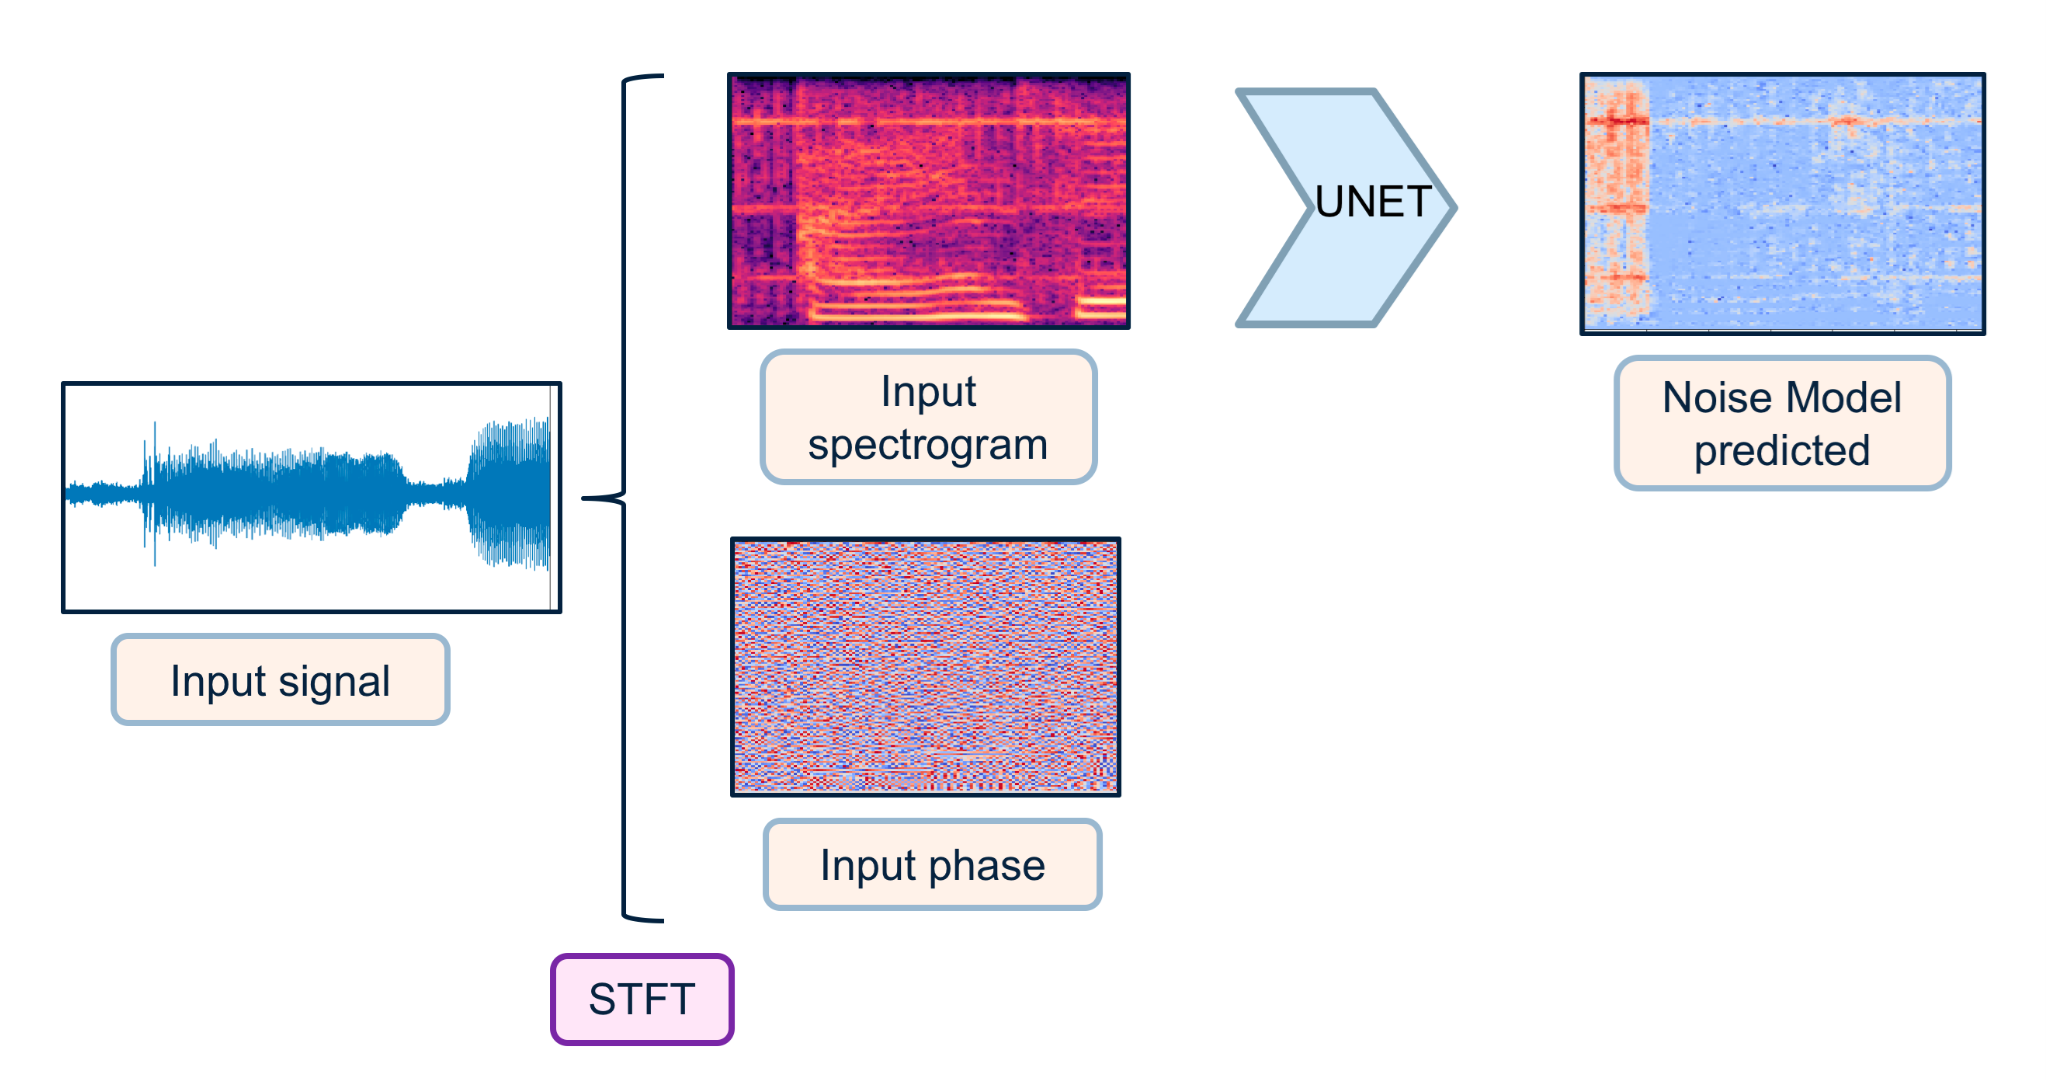
音频通过环形缓冲区 从麦克风采集输入,确保连续逐帧处理。原始音频帧经过频谱变换流水线,利用短时傅里叶变换 (STFT) 将时域信号转换到频域。
2. 神经网络噪声识别
频域表示会经过归一化和缩放,以满足神经网络输入要求。预处理后的频谱图 送入NPU上运行的神经网络,由网络识别音频中的噪声成分并输出噪声预测掩码。
3. 信号重建与增强
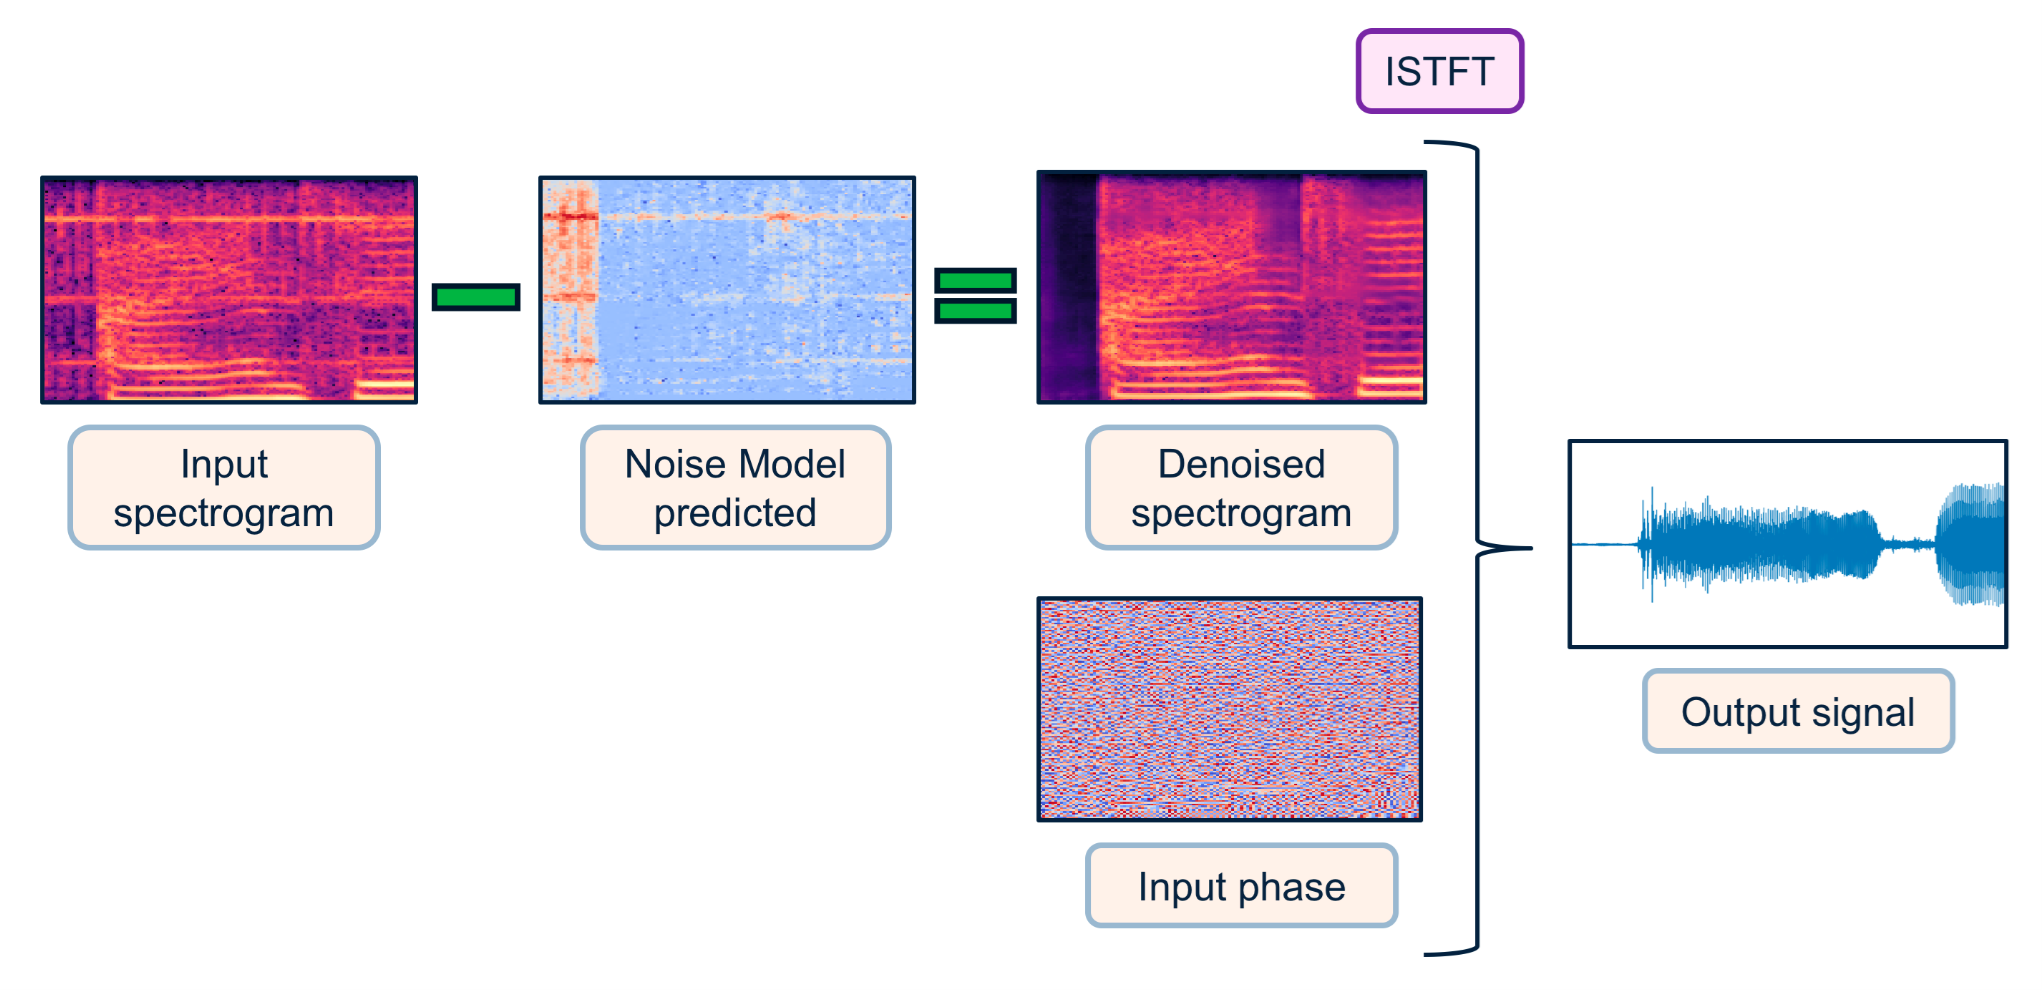
在频域中从原始信号中减去 预测噪声。降噪后的频谱表示会经过后处理,包括重新应用相位和逆变换,以重建时域信号。额外的增强滤波器可提升语音清晰度和可懂度。随后,清理后的音频发送到输出设备进行实时播放。
技术细节
该方案将深度学习 与传统数字信号处理 技术相结合。它在STM32N6硬件上实现基于神经网络的频谱噪声抑制 系统,并利用NPU 进行高效推理。
- 实时处理:逐帧降噪,延迟极低,适合实时通信
- 高降噪性能:在抑制噪声的同时保持语音可懂度和自然度
- 资源需求低:针对存储和处理能力有限的嵌入式系统进行了优化
- 自适应噪声处理:对平稳和非平稳噪声均有效
- 语音增强: 额外的DSP技术可在降噪之外进一步提升语音清晰度
- 高能效:针对低功耗进行了优化,帮助便携式应用延长电池续航
传感器
STM32N6570-DK 开发板上集成了数字MEMS麦克风 (U13)。MEMS麦克风负责采集音频输入,音频插孔 (CN15) 则提供降噪后的音频输出,用于实时处理演示。
模型与结果
模型:
- 基于UNet的音频降噪神经网络
- 通过ModelNova (embedUR) 针对设备端部署进行优化和量化
- 总训练轮数:50(NPU硬件46轮,CPU软件4轮)
结果:
- Flash (octoFlash):4 MB中的1.863 MB (46.58%) 用于权重
- CPU RAM:1 MB完全用于激活 (100%)
- NPU RAM:总计1.344 MB,其中1.322 MB (98.36%) 用于激活
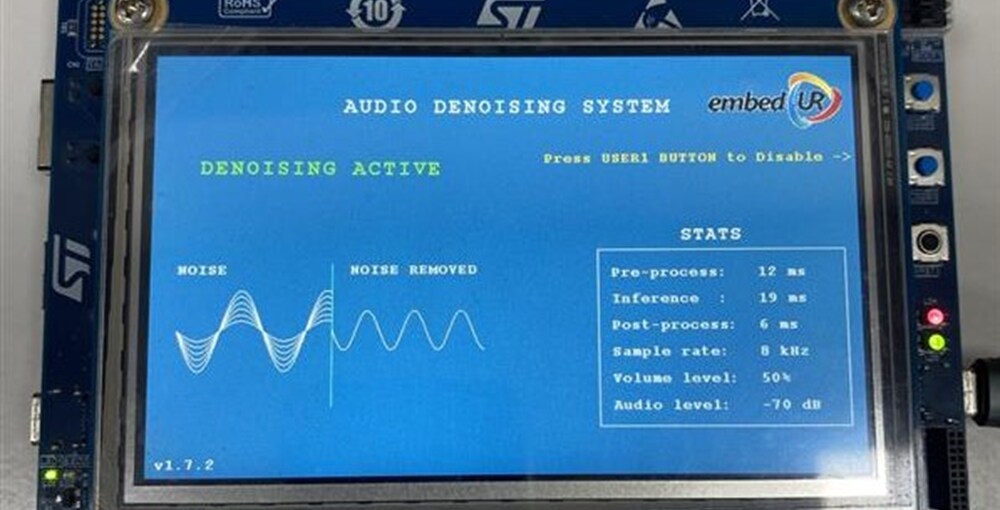
- 预处理时间:12 ms
- 神经网络推理:19 ms
- 后处理时间:5 ms
- 总处理时间:36 ms
软件工具
- STM32Cube AI Studio,用于神经网络转换与部署
- ST Edge AI Core 命令行接口
- STM32CubeIDE,用于应用开发和调试
- STM32CubeProgrammer, 用于将固件烧录到目标设备
文档

资源
通过STM32Cube AI Studio优化
STM32Cube AI Studio是一款桌面工具,用于评估、优化和编译STM32微控制器的神经网络模型。该工具完全支持针对Neural-ART加速器神经处理单元 (NPU) 的编译。它取代了意法半导体AI产品线中的X-CUBE-AI,以涵盖新款STM32器件。
最适用于STM32N6系列
STM32系列32位微控制器基于Arm Cortex®-M处理器,旨在为MCU用户提供新的开发自由度。该系列产品结合了高性能、实时功能、数字信号处理、低功耗/低电压操作和出色的连接性,同时保持高度集成和易于开发的特点。